2026년 1월 3일에 작성되었고, 블로그를 이전하며 옮겨온 포스트입니다.
여기에서 원본을 확인할 수 있습니다.
들어가며
이 글에서는 Spring Boot, MariaDB, Elasticsearch를 활용해 1,000만 건의 데이터를 검색하는 과정을 다룰 예정이다. 기존 JPA LIKE 검색 방식과 ES를 도입한 방식을 비교하며 대규모 데이터의 검색 속도를 개선하는 방법에 대해 살펴보겠다.
Elasticsearch란?
Elasticsearch는 Apache Lucene 기반의 오픈소스, 분산, RESTful 검색 엔진이다. 대량의 데이터를 실시간에 가까운 속도로 검색하고 분석할 수 있다.
특징
- Inverted Index
- “The quick brown fox jumps over the” 라는 문장을 하나의 열로 저장하는게 아닌 단어 별로 인덱싱 하기 떄문에 데이터를 빠르게 찾을 수 있다.
- Scalability
- ES는 데이터를 여러 개의 ‘Shard’로 쪼개 여러 서버에 분산하여 저장한다. 그래서 데이터가 늘어나게 되면, 서버만 추가하면 끝이다.
- Schemaless
- RDB처럼 테이블의 구조를 엄격하게 정의하지 않아도 된다. JSON 문서 형태로 데이터를 보내면 ES가 Dynamic Mapping을 통해 필드 타입을 자동으로 추론해 인덱싱한다.
- Full-Text Search
- ‘Nori’와 같은 형태소 분석기를 이용해 “저장하다”, “저장하는”을 “저장”이라는 어근으로 파악해 검색 결과를 도출한다. 이렇게 되면 더 정확한 검색 결과를 사용자에게 제공할 수 있다.
기존 JPA를 활용한 데이터 검색
JPA를 활용한 기존 RDB의 LIKE 검색을 위해 코드를 작성했다.
테스트를 위한 코드 작성하기
// ProductController.java

@RestController
@RequestMapping("/api/product")
@RequiredArgsConstructor
public class ProductController {
    private final ProductService productService;

    @GetMapping("/")
    public List<ProductResponseDto> searchProduct(@RequestParam String keyword) {
        return productService.searchProduct(keyword);
    }
}
// ProductResponseDto.java
@Data
@Builder
@AllArgsConstructor
@NoArgsConstructor
public class ProductResponseDto {
private Long id;
private String productName;
private String uploadedAt;
}// Product.java
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
@Entity
@Table(name = "product")
public class Product {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(nullable = false)
private String name;
@CreationTimestamp
private LocalDateTime uploadedAt;
}// ProductRepository.java
public interface ProductRepository extends JpaRepository<Product, Long> {
List<Product> findAllByNameContaining(String name);
}// ProductService.java
@Service
@RequiredArgsConstructor
public class ProductService {
private final ProductRepository productRepository;
public List<ProductResponseDto> searchProduct(String keyword) {
List<Product> productList = productRepository.findAllByNameContaining(keyword);
List<ProductResponseDto> productResponseDtoList = new ArrayList<>();
for(Product product : productList) {
productResponseDtoList.add(
ProductResponseDto.builder()
.id(product.getId())
.productName(product.getName())
.uploadedAt(product.getUploadedAt().toString())
.build()
);
}
return productResponseDtoList;
}
}위 코드로 아래의 기능을 완성했다.
- Product Entity 생성
- Product의 데이터를 키워드로 검색
1,000만 개의 데이터 만들기
1,000만 개의 데이터를 하나하나 수작업으로 진행하기엔 너무 많은 시간이 걸리니 GPT의 힘을 빌려 1,000만 개의 무작위 데이터를 만드는 Python 코드를 사용했다. 무작위 데이터 생성이 필요하신 분들은 아래 코드를 사용해도 좋다.
import mysql.connector
from mysql.connector import Error
import random
import string
from datetime import datetime

def generate_random_name(length=10):
    letters = string.ascii_letters + string.digits
    return ''.join(random.choice(letters) for i in range(length))

def insert_dummy_data(host, database, user, password, total_count=100000, batch_size=10000):
    connection = None
    try:
        connection = mysql.connector.connect(
            host=host,
            database=database,
            user=user,
            password=password
        )

        if connection.is_connected():
            cursor = connection.cursor()

            query = "INSERT INTO product (name, uploaded_at) VALUES (%s, %s)"

            inserted_count = 0
            while inserted_count < total_count:
                data_batch = []
                for _ in range(batch_size):
                    name = f"Product_{generate_random_name()}"
                    uploaded_at = datetime.now()
                    data_batch.append((name, uploaded_at))

                cursor.executemany(query, data_batch)
                connection.commit()

                inserted_count += batch_size
                print(f"진행 상황: {inserted_count}/{total_count} 완료...")

            print(f"{total_count}개의 데이터가 삽입 됨.")

    except Error as e:
        print(f"오류 발생: {e}")
    finally:
        if connection and connection.is_connected():
            cursor.close()
            connection.close()
            print("MariaDB 연결 종료 됨")

if __name__ == "__main__":
    insert_dummy_data(
        host="HOST",
        database="DATABASE",
        user="USER",
        password="PASSWORD",
        total_count=10000000,
        batch_size=5000
    )
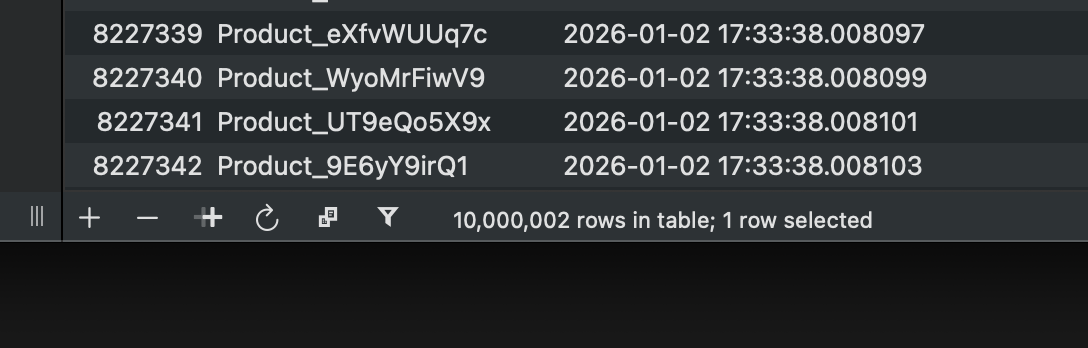
이렇게 코드를 실행하고 데이터베이스를 조회해 보면, 약 1,000만 개의 행이 추가되어 있는 것을 확인할 수 있어요. 이렇게 되면 테스트를 위한 준비는 모두 끝났다.
API 호출해서 테스트하기
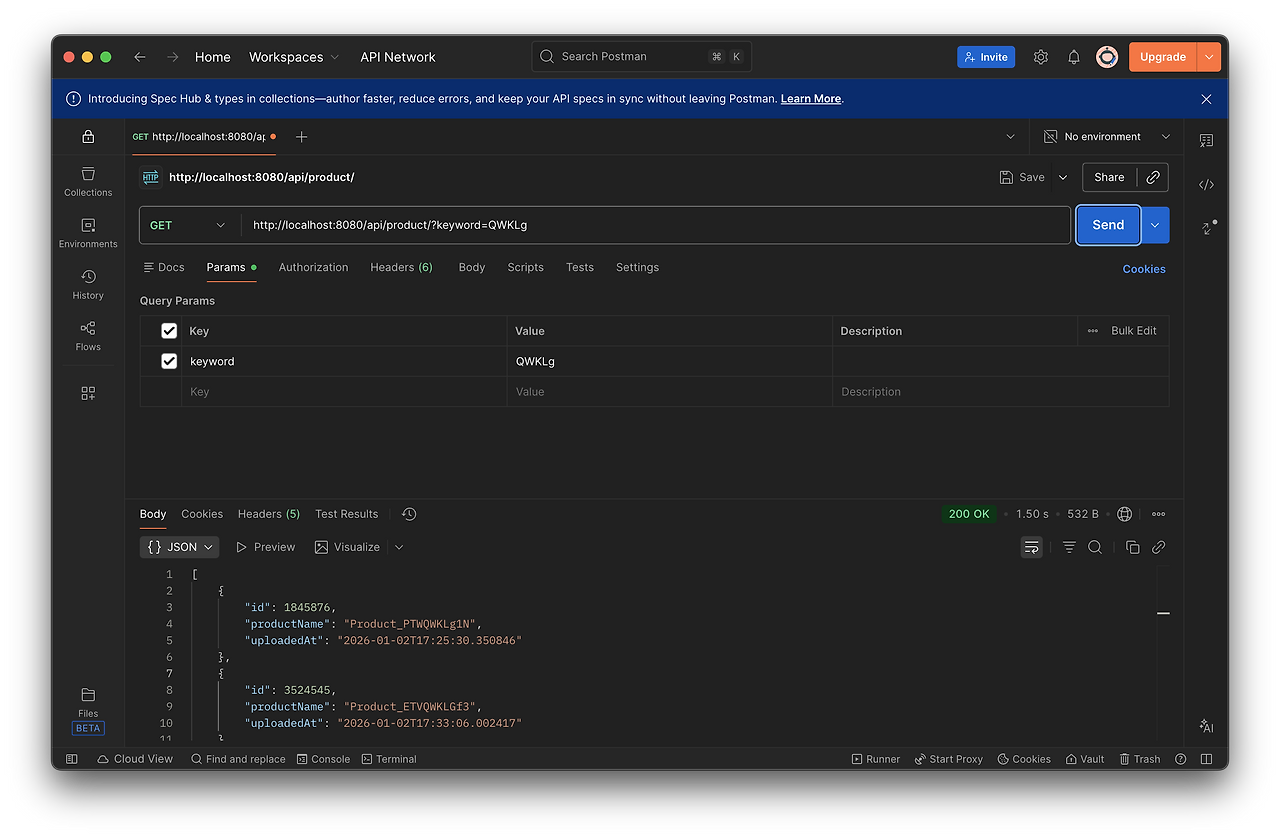
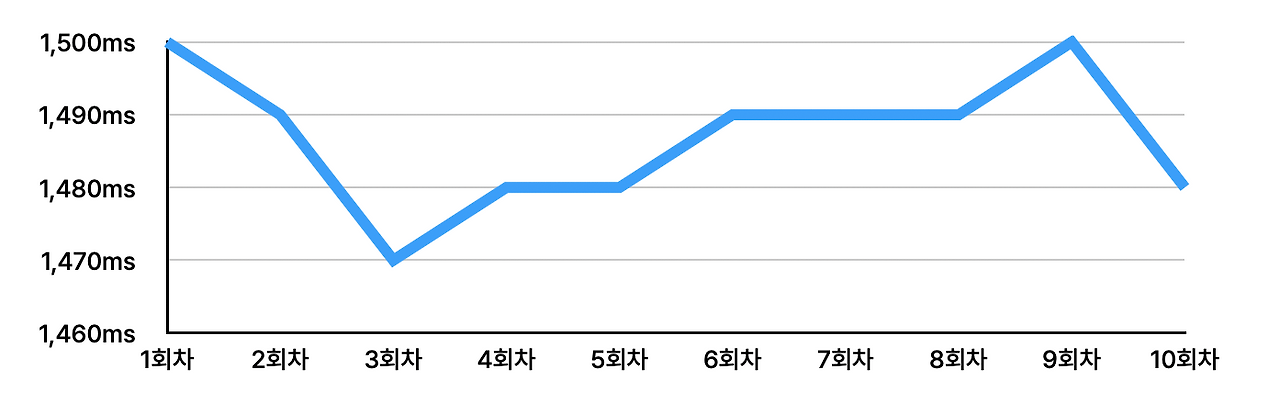
/api/product/?keyword="키워드"에 요청을 보내 기존 RDB의 LIKE 검색을 통한 응답 시간을 체크해봤다. 그 결과, 복잡한 조건이나 데이터를 넣지 않았음에도 불구하고 약 1.5초 정도의 늦은 응답 시간을 기록했다. 10번 정도 요청한 응답 시간을 그래프로 나타냈으니 참고하면 된다.
Elasticsearch 도입하기
기존 코드 수정하기
이제 기존 Product엔티티에 Elasticsearch를 도입하려고 한다. Product는 JPA를 이용한 Entity이고, ProductDocument는 Elasticsearch의 문서이다. 즉, Product는 행과 열로 이루어져 있고, ProductDocument는 JSON 문서 형태로 되어있다.
그래서 코드를 수정하여, Elasticsearch의 설정, ProductDocument 생성, Elasticsearch를 이용한 검색 기능을 추가한다.
build.gradle에 Elasticsearch 의존성 추가
implementation 'org.springframework.boot:spring-boot-starter-data-elasticsearch'application.yml에 Elasticsearch 설정 추가
spring:
  elasticsearch:
    uris: localhost:9200
// ProductController.java
@GetMapping("/sync")
public void syncAllProduct() {
productService.syncAllProduct();
}
@GetMapping("/es")
public List<ProductResponseDto> searchProductByEs(@RequestParam String keyword) {
return productService.searchProductByEs(keyword);
}// ProductDocument.java
@Getter
@Setter
@Builder
@Document(indexName = "product")
public class ProductDocument {
@Id
private Long id;
@Field(type = FieldType.Text, analyzer = "nori")
private String name;
@Field(type = FieldType.Date, format = {DateFormat.date_hour_minute_second_millis, DateFormat.epoch_millis})
private LocalDateTime uploadedAt;
}// ProductDocumentRepository.java
public interface ProductDocumentRepository extends ElasticsearchRepository<ProductDocument, Long> {
List<ProductDocument> findByNameContaining(String name);
}// ElasticConfiguration.java
@Configuration
@EnableElasticsearchRepositories
public class ElasticConfiguration extends ElasticsearchConfiguration {
@Value("${spring.elasticsearch.uris}")
private String host;
@Override
public ClientConfiguration clientConfiguration() {
return ClientConfiguration.builder()
.connectedTo(host)
.build();
}
}Elasticsearch와 MariaDB 간 데이터 Sync 작업
프로젝트 내에서 모든 비즈니스 로직과 데이터 트랜잭션은 RDB를 중심으로 일어난다. 그렇기 떄문에 ES와 RDB 간 데이터 일관성을 유지하려면 ES와 RDB간 데이터를 동기화하는 작업이 필요하다. 또한, 당연한 이야기이지만 RDB와 ES는 데이터를 저장하는 방식이 다르기 때문이다. (+ 그래서 여기서 유의해야 할 사항은, 데이터를 저장할 때에는 RDB 뿐만 아니라 ES에도 함께 저장(요청)해야 한다.)
테스트 해보기
(1,000만 건의 데이터를 2,000개씩 쪼개 ES에 인덱싱하는데 많은 시간이 걸렸다..) 이제, 기존 RDB를 이용한 검색을 다시 테스트하면?
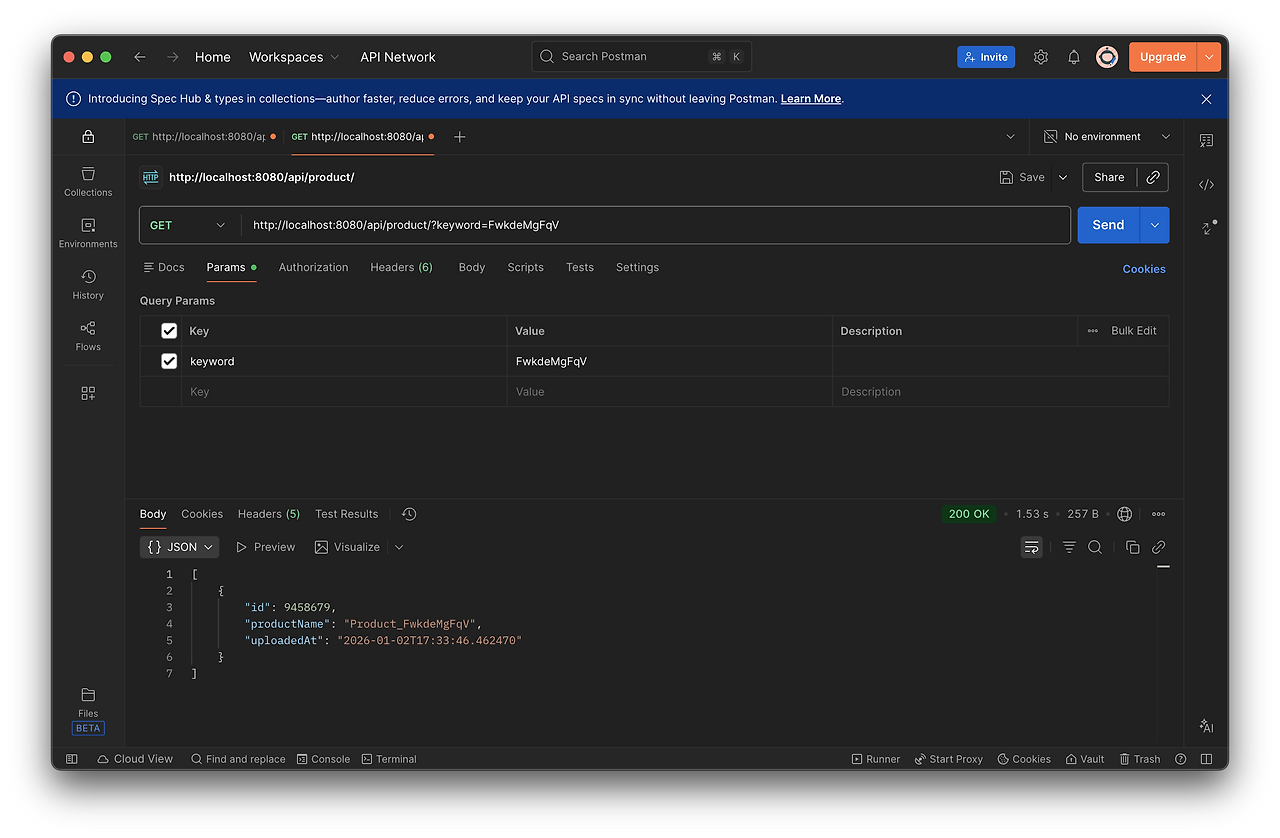
(데이터가 변한게 없기 때문에) 이전과 동일하게 약 1.5초 정도 응답 시간을 보여주는 것을 확인할 수 있다. 이제, Elasticsearch를 통한 검색을 테스트해본다면
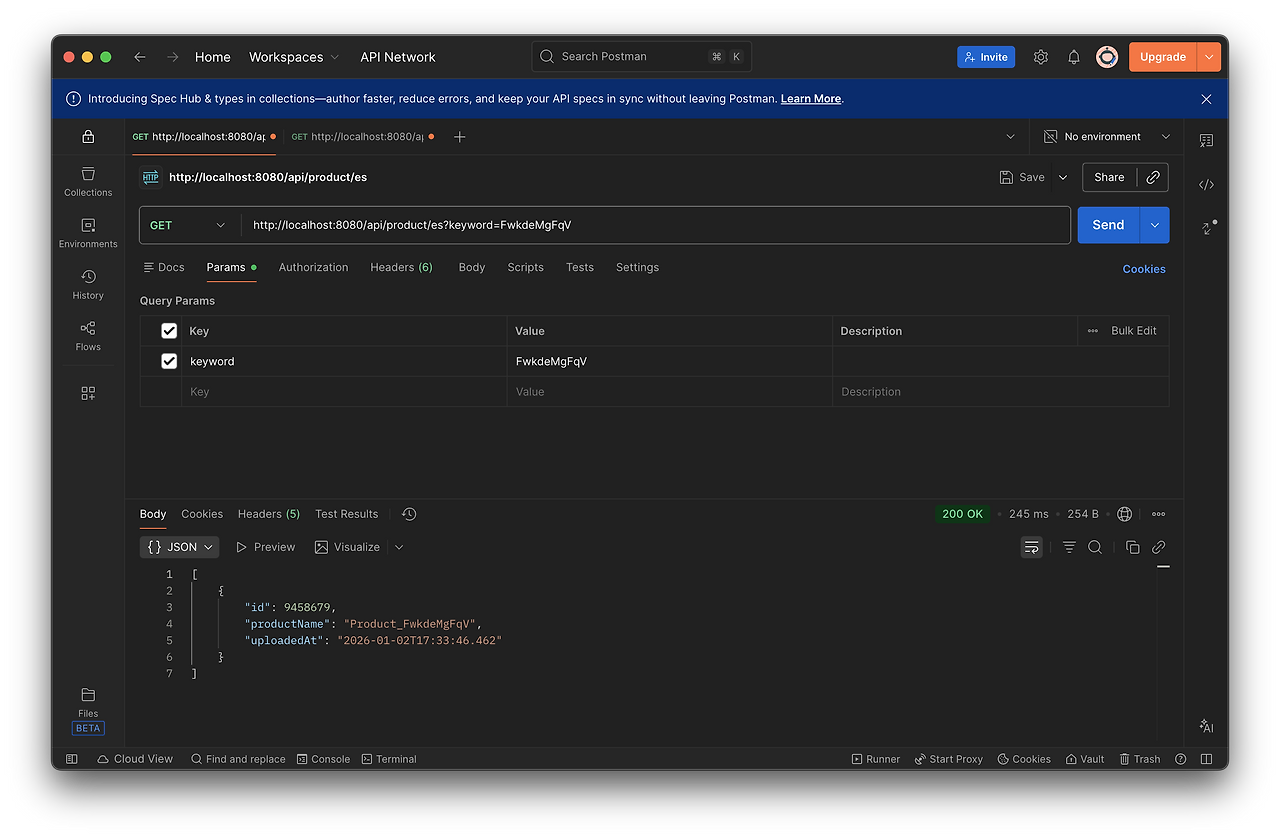
응답시간이 약 0.25초(245ms) 소요되었다. 1.5초 걸리던 기존 RDB 조회 방식에 비해 약 6배의 응답 시간이 단축되었다는 것을 확인할 수 있었다. 현재는 project 테이블에 있는 데이터가, id, name, uploaded_at 3가지 데이터 밖에 없어 조회 속도가 많이 차이나지 않는 것으로 보이지만, 검색 조건이 복잡해 진다면 이 차이는 어마무시하게 벌어질 것이라고 예상한다.
응답 시간을 기준으로 언제 사용자가 가장 많이 이탈할까?
아래 표를 보면, 이 실험에서 1.5초 정도 응답 시간을 보여주는 API는 사용자의 입장으로는 느리다는 것이 체감되는 정도이지만, 아직 참을 만한 구간이다. 하지만 우리는 테스트 코드이기에 복잡한 데이터가 없음에도 1.5초라는 응답 시간을 보여줬으니 실제 서비스에서는 훨씬 더 늦은 응답 속도를 보여줄 거다.
| 응답 시간 | 사용자 반응 |
| ~0.1초 | 즉각적으로 반응함. 이탈률 매우 낮음. |
| ~1초 | 짧은 지연은 느끼지만, 부드럽다고 느낌. 이탈률 낮음. |
| 1초 ~ 2초 | 느리다는 것이 체감되지만, 아직 참을만 함. |
| 2초 ~ 3초 | 눈에 띌 정도로 느림. 첫 화면이나 로딩 화면에서는 인내심이 떨어짐. |
| 3초 ~ 5초 | ‘느리다’라는 확신을 가짐. 뒤로가기나 서비스 이탈이 커짐. |
| 5초~ | ‘멈췄다’라고 느낌. 앱을 강제로 종료할 수 있음. |
그렇기 때문에 Elasticsearch를 도입해 데이터를 인덱싱하여 사용자에게 빠른 응답 속도를 보여주는 것이 이탈률을 낮출 수도 있고 이는 결국 사용자의 좋은 경험으로 되돌아올 것이다.
마무리
지금까지 프로젝트를 진행하면서 대규모의 데이터를 다뤄볼 일은 없었다. 하지만, 요즘 채용 공고들을 둘러보면 ES를 다루는 기업들이 점점 많아지는 것을 확인했다. 조금이라도 폭 넓게, 다양하게, 깊이 이해해 보고 싶어서 대규모 데이터를 생성해 ES로 데이터를 검색하는 과정을 경험해봤다.
직접 ES를 사용해보고, 응답 속도가 엄청나게 줄어드는 것을 확인하니 왜 기업들이 점점 도입을 많이하는지 알게되었다. 실질적인 서비스에서는 대부분 데이터를 저장하는 일보다는 조회하는 일이 많을테니까...
그래서 추후 진행될 사이드 프로젝트에도 ES를 적용해보면 좋을 것 같아서 기회가 된다면 도입기도 한 번 남겨보면 좋겠다고 생각했다.
'Backend > Java' 카테고리의 다른 글
| 어? 이제 RestTemplate은 Spring에서 권장하지 않는다구? (0) | 2026.08.23 |
|---|---|
| 서비스에 AI 붙이기: Spring AI + Ollama + Function Calling (0) | 2026.08.23 |
| AWS 탈탈 털리고, Amazon Lightsail을 이용해 안전하게 파일 업로드 해보기 (Spring Boot) (0) | 2026.08.23 |
| Java Spring Boot에서 템플릿을 설정하고 이메일 발송하기 (0) | 2026.08.23 |
| 값이 반드시 유효해야 할 때: Spring Boot에서 Validation 처리하기 (0) | 2026.08.22 |