2026년 3월 15일에 작성되었고, 블로그를 이전하며 옮겨온 포스트입니다.
여기에서 원본을 확인할 수 있습니다.
프로젝트를 만드는 데에 AI 사용은 이제 선택이 아닌 필수라고 생각한다. 그래서 프로젝트에 AI를 어디에 사용할 것인지에 대해서는 생각해둔 부분은 많지만 막상 구현을 해보려니 어디서부터 시작해야 할지 방향이 잡히지 않는 부분이 많아 프로젝트에 사용하기 전에 공부를 해보기로 생각했다.
원래 생각했던 방식
공부를 하기 전, 원래 생각했던 방식은 아래와 같다.
- GPT-4, GPT-5 등과 같은 모델을 사용할 수 있는 OpenAI API 사용하기
- Spring Boot에서 API 요청
- 이 때, 서비스에 맞는 프롬프트와 데이터를 텍스트 형식으로 제공
- 생성된 답변을 Response
AI를 사용할 수 있는 방식들
- 검색 증강 생성(RAG, Retrieval-Augmented Generation)
- 파인 튜닝(Fine-Tuning)
- 프롬프트 엔지니어링(Prompt Engineering)
1. 검색 증강 생성(RAG, Retrieval-Augmented Generation)
검색 증강 생성은 AI에게 모든 데이터를 학습시키는 대신, 외부 데이터에서 정보를 찾아 답변에 활용할 수 있도록 하는 방식이다. 이 글에서는 RAG 방식을 사용할 예정이다.
- 사용자가 질문 요청 → 관련 문서 검색 → 검색한 내용을 참고하여 답변 생성
- 자주 바뀌는 DB 데이터도 AI가 최신 정보를 이용하여 답변
- 답변의 근거(출처)가 명확하고, 환각 현상 감소
- 파인 튜닝에 비해 모델을 새로 학습시킬 필요가 없어 저렴
2. 파인 튜닝(Fine-Tuning)
이미 학습된 거대 모델(Pre-trained LLM)을 특정 데이터로 다시 학습시키는 방식이다.
- 특정 데이터셋으로 학습시키기 떄문에 특정 말투나, 용어, 형식을 완벽하게 응답
- 외부 DB 연결 없이도 내부 지식으로 빠른 답변이 가능
- 학습을 위한 고성능 사양과 많은 양의 정제된 데이터 필요
- 바뀌는 데이터에 대응할 수 없기 때문에 데이터가 바뀌면 모델을 다시 학습 시켜야 함
3. 프롬프트 엔지니어링(Prompt Engineering)
모델을 따로 학습시키지 않고, AI에 주는 프롬프트를 정교하게 정리해서 원하는 결과 값을 유도하는 방식이다.
- 원하는 결과 값이 도출되지 않는다면 프롬프트를 수정하는 것 만으로도 즉시 개선할 수 있음
- 학습을 위한 고성능 사양이나 데이터가 필요하지 않음
- 사용하는 모델이 모르는 지식을 창조할 순 없음
그래서 내가 선택한 방식은
검색 증강 생성 방식을 선택했다. 자주 변경되는 데이터에 대해 최신 정보를 제공하고 원하는 답변을 얻는게 목표였기 때문에 프롬프트를 작성하고, 관련된 데이터를 실시간으로 제공해서 AI가 참고해서 답변을 생성할 수 있도록 하고 싶다.
시작하기
이 글에서 사용 될 모델은 gpt-oss:20b 이고, 해당 모델에 대한 정보는 여기에서 자세히 확인할 수 있다. OpenAI가 2025년 8월에 공개한 상업적 활용이 가능한 모델이다. Ollama를 통해 해당 모델을 다운로드한다.
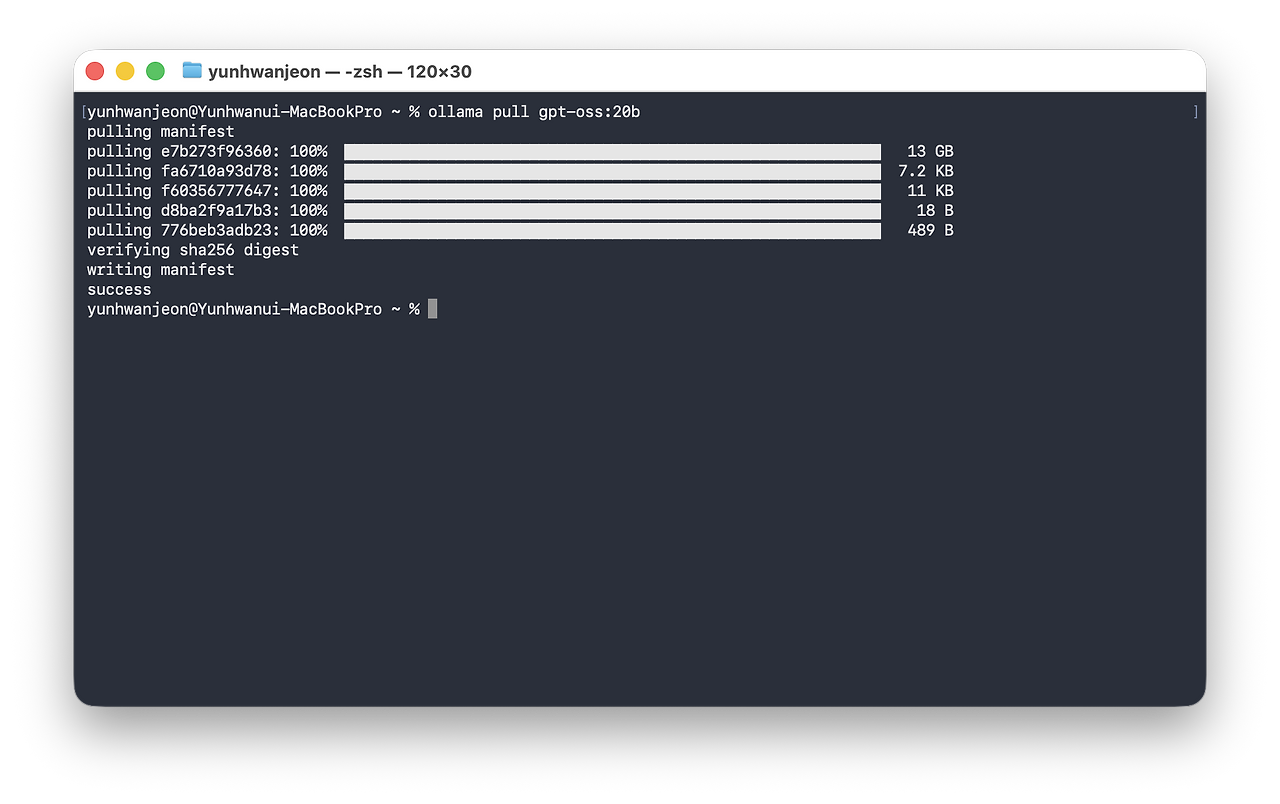
ollama pull gpt-oss:20b위 명령어를 통해 모델을 다운로드하고, Ollama 앱을 실행시킨 상태로 유지한다.
기본 테스트 프로젝트 만들기
먼저, Spring Boot에서 Ollama를 사용할 수 있도록 의존성을 추가한다.
implementation 'org.springframework.ai:spring-ai-starter-model-ollama'이후, 사용할 모델에 대해 application.yml에서 설정해준다. 이 값을 가지고 어떤 모델을 사용할지 결정된다.
spring:
  ai:
    ollama:
      base-url: http://localhost:11434
      chat:
        options:
          model: gpt-oss:20b
          temperature: 0.1
여기서 temperature은 응답 창의성과 무작위성을 조절하느 값이다. 값이 커질수록 창의성이 높아진다고 생각하면 되고, 이렇게 데이터 분석과 같은 행위를 할 때에는 위 설정처럼 0.1정도가 적당하다.
먼저, 어떤 AI를 만들고자 하냐면,
- 사용자 데이터의 학과 수, 학과 명으로 통계 생성
- 특정 학과에 어떤 사용자가 존재하는지
이런 질문에 답변할 수 있는 챗봇을 만들어 볼 예정이다.
// User.java

@Getter
@Setter
@NoArgsConstructor
@AllArgsConstructor
@Builder
@Entity
@Table(name = "user")
public class User {
    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false, unique = true)
    private String email;

    @Column(nullable = false)
    private String name;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false)
    private SchoolDepart schoolDepart;
}
SchoolDepart.java
@Getter
@RequiredArgsConstructor
public enum SchoolDepart {
MECHANICAL_ENGINEERING("기계공학과"),
MATERIALS_ENGINEERING("재료공학과"),
INDUSTRIAL_ENGINEERING("산업공학과"),
AUTOMOTIVE_ENGINEERING("자동차공학과"),
ELECTRICAL_ENGINEERING("전기공학과"),
ELECTRONIC_ENGINEERING("전자공학과"),
ELECTRICAL_ELECTRONIC_ENGINEERING("전기전자공학과"),
SEMICONDUCTOR_ENGINEERING("반도체공학과"),
COMPUTER_SCIENCE("컴퓨터공학과"),
SOFTWARE_ENGINEERING("소프트웨어공학과"),
INFORMATION_COMMUNICATION("정보통신공학과"),
AI_ENGINEERING("인공지능학과"),
CYBERSECURITY("정보보안학과"),
CIVIL_ENGINEERING("토목공학과"),
ARCHITECTURAL_ENGINEERING("건축공학과"),
URBAN_ENGINEERING("도시공학과"),
ENVIRONMENTAL_ENGINEERING("환경공학과"),
CHEMICAL_ENGINEERING("화학공학과"),
ENERGY_ENGINEERING("에너지공학과"),
NUCLEAR_ENGINEERING("원자력공학과"),
BIOMEDICAL_ENGINEERING("의공학과"),
BIOTECHNOLOGY("바이오공학과");
private final String displayName;
}이렇게 User에 대한 Entity와 학과 ENUM을 생성해 주고,
// UserRepository.java

@Repository
public interface UserRepository extends JpaRepository<User, Long> {
    @Query("SELECT u.schoolDepart, COUNT(u) FROM User u GROUP BY u.schoolDepart")
    List<Object[]> findDepartmentStats();

    @Query("SELECT u FROM User u WHERE u.schoolDepart = :depart")
    List<User> findUsersByDepart(@Param("depart") SchoolDepart depart);
}
AI가 도구(쿼리)를 통해 데이터를 얻을 수 있도록 세팅해준다. 학과 별 사용자 수, 특정 학과에 소속된 사용자의 정보를 받을 수 있는 쿼리를 작성했다.
// OllamaConfiguration.java

@Configuration
public class OllamaConfiguration {
    @Bean
    @Description("학과 별 통계 정보를 가져옵니다. 학과 명과 인원 수를 조회합니다.")
    public Function<Void, String> findDepartmentStats(UserRepository userRepository) {
        return unused -> userRepository.findDepartmentStats().stream()
                .map(row -> {
                    SchoolDepart schoolDepart = (SchoolDepart) row[0];
                    Long count = (Long) row[1];
                    return schoolDepart.getDisplayName() + ": " + count + "명";
                })
                .collect(Collectors.joining("\n"));
    }

    @Bean
    @Description("특정 학과에 속한 사용자 목록을 조회합니다. 학과 ENUM 값을 입력하면 해당 학과 학생들의 이름과 이메일을 반환합니다.")
    public Function<String, String> findUsersByDepart(UserRepository userRepository) {
        return departName -> {
            SchoolDepart depart = SchoolDepart.valueOf(departName);
            List<User> users = userRepository.findUsersByDepart(depart);

            if (users.isEmpty()) {
                return depart.getDisplayName() + "에 등록된 사용자가 없습니다.";
            }

            return users.stream()
                    .map(user -> user.getName() + " (" + user.getEmail() + ")")
                    .collect(Collectors.joining("\n"));
        };
    }
}
이후, AI가 사용할 수 있는 도구들을 선언해준다. AI는 @Description에 있는 설명을 통해 어떤 도구를 사용할지 결정하기 떄문에 @Description을 이해하기 쉽게, 직관적으로 자세히 적어주는 것이 좋다.
// OllamaService.java

@Service
@RequiredArgsConstructor
public class OllamaService {
    private final ChatModel chatModel;

    public String analyzeDepartment(String msg) {
        String departList = Arrays.stream(SchoolDepart.values())
                .map(d -> "- %s (%s)".formatted(d.getDisplayName(), d.name()))
                .collect(Collectors.joining("\n"));

        SystemMessage systemMessage = new SystemMessage("""
                너는 사용자의 정보와 학과 정보로 질문을 받으면 그거에 관해 분석하여 답변하는 AI 비서야.
                모든 답변은 데이터를 기반으로 생성해야 하고, 절대 거짓된 정보를 생성하면 안 돼.
                데이터가 없거나 부정확한 경우 답변을 하지 않아야 해. 또는 사용자에게 데이터를 찾을 수 없다고 알려야 해.

                학과 정보는 아래 목록만 유효하며, 이 외의 학과는 존재하지 않는 것으로 간주해야 해.
                각 항목은 "한국어 학과명 (ENUM 키)" 형식으로 제공돼.

                [등록된 학과 목록]
                %s

                답변 시 반드시 아래 규칙을 따라야 해:
                1. 학과 이름은 항상 한국어 명칭으로 표시해.
                2. 통계 데이터(인원 수, 비율 등)는 제공된 수치만 사용하고 임의로 계산하거나 추정하지 마.
                3. 특정 학과 학생 목록 요청 시 제공된 데이터 안에서만 답변해.
                4. 복수의 학과를 비교하거나 분석할 때는 객관적인 수치 기반으로만 서술해.
                5. 답변은 한국어로 작성해.
                """.formatted(departList));
        UserMessage userMessage = new UserMessage(msg);

        OllamaChatOptions options = OllamaChatOptions.builder()
                .toolNames("findDepartmentStats", "findUsersByDepart")
                .build();

        var response = chatModel.call(new Prompt(List.of(systemMessage, userMessage), options));

        return response.getResult().getOutput().getText();
    }
}
이제 AI에게 페르소나를 부여해준다. 학과 같은 경우에는 텍스트 값이 아닌 ENUM 값을 사용하였기 때문에 ENUM 키에 대한 한글 명칭을 프롬프트에 함께 제공하였다.
// OllamaController.java

@RestController
@RequestMapping("/api/ollama")
@RequiredArgsConstructor
public class OllamaController {
    private final OllamaService ollamaService;

    @PostMapping("/chat")
    public String chat(@RequestParam String msg) {
        return ollamaService.analyzeDepartment(msg);
    }
}
그리고 /api/ollama/chat에 POST요청을 보내면서 msg 파라미터 값으로 메시지를 보내면 답변을 받을 수 있도록 Controller도 구성하였다.
사용해보기
이걸 테스트 해보려고 하나하나 데이터 행을 만드는 것은 (귀찮은) 일이기 때문에 Claude에게 Python으로 랜덤 사용자 데이터를 생성해달라고 요청했고 Python 코드를 실행하여 약 100개 정도의 테스트 데이터를 생성했다.
이제 http://localhost:8080/api//ollama/chat으로 POST 요청을 보내 AI가 어떤 답변을 하는지 확인해보자.
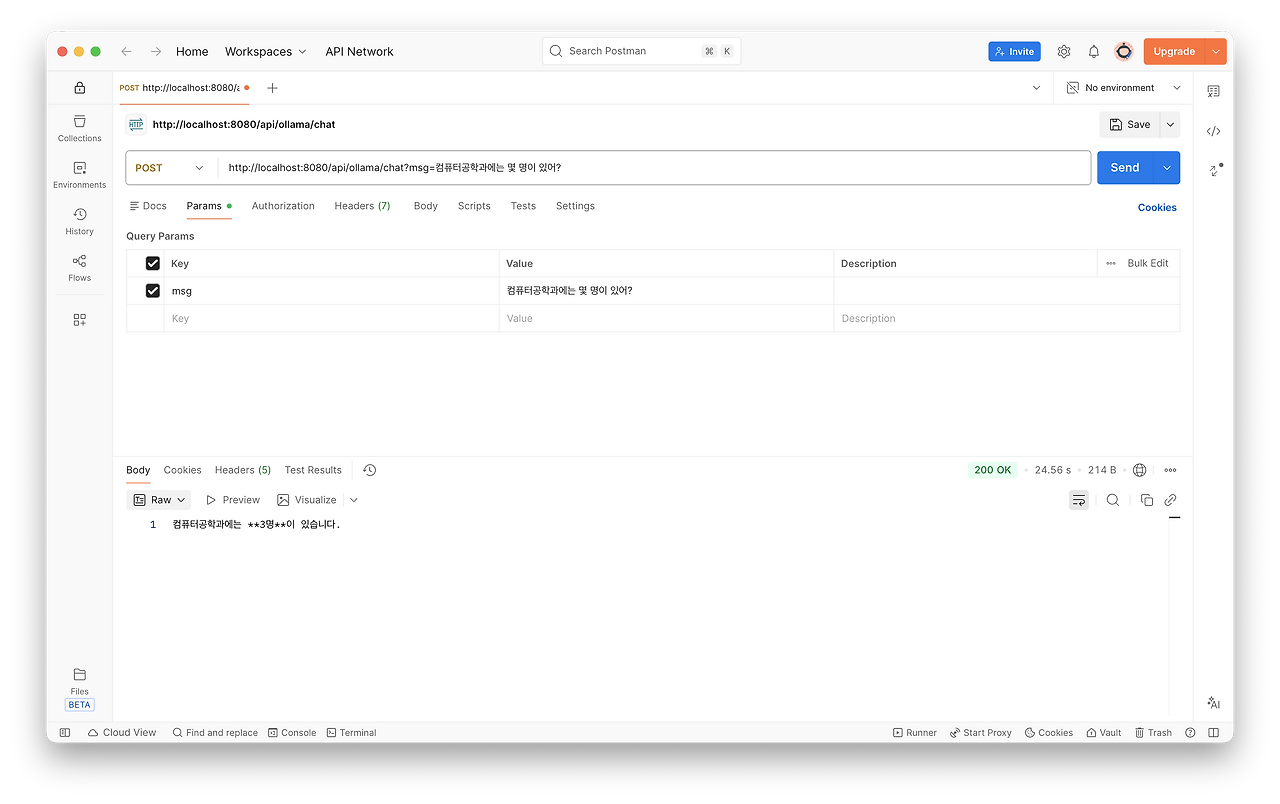
LLM 모델을 맥북에서 로컬로 돌리기 때문에 살짝 시간이 오래 걸렸긴 한데, 정확한 답변을 하는 것을 볼 수 있다. 데이터베이스의 실제 데이터를 살펴보면

이런식으로 AI가 말했던 3개의 데이터가 존재함을 확인할 수 있다. 학과 별 통계도 내보면.
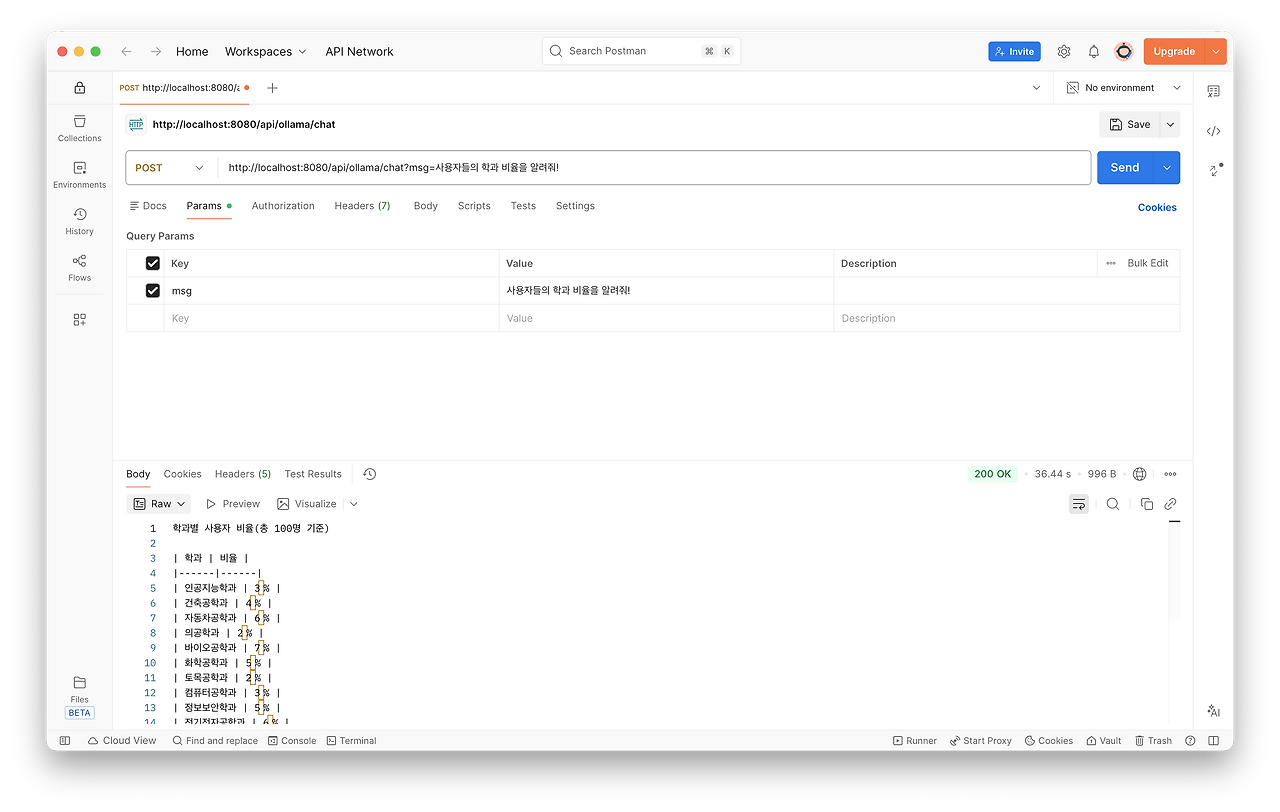
학과별 사용자 비율(총 100명 기준)

| 학과 | 비율 |
|------|------|
| 인공지능학과 | 3 % |
| 건축공학과 | 4 % |
| 자동차공학과 | 6 % |
| 의공학과 | 2 % |
| 바이오공학과 | 7 % |
| 화학공학과 | 5 % |
| 토목공학과 | 2 % |
| 컴퓨터공학과 | 3 % |
| 정보보안학과 | 5 % |
| 전기전자공학과 | 6 % |
| 전기공학과 | 5 % |
| 전자공학과 | 4 % |
| 에너지공학과 | 3 % |
| 환경공학과 | 6 % |
| 산업공학과 | 3 % |
| 정보통신공학과 | 7 % |
| 재료공학과 | 5 % |
| 기계공학과 | 3 % |
| 원자력공학과 | 5 % |
| 반도체공학과 | 6 % |
| 소프트웨어공학과 | 3 % |
| 도시공학과 | 7 % |

(각 비율은 해당 학과의 인원 수를 전체 100명으로 나눈 값입니다.)
이런식으로 정확하게 통계도 만들어내주는 것을 볼 수 있다.
마무리
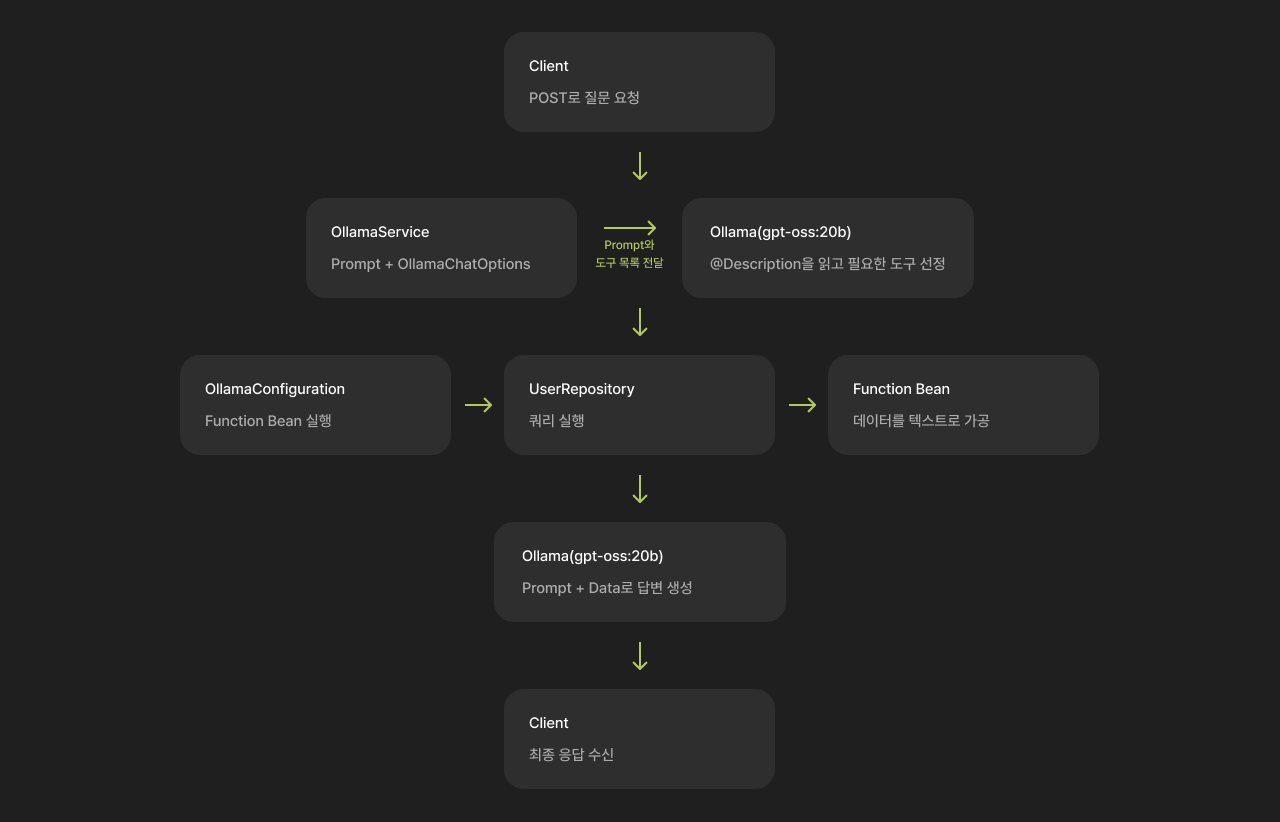
위 코드는 위와 같은 흐름도 대로 작동한다.
- 클라이언트에서 요청을 보냄
- OllamaService에서 SystemMessage와 OllamaChatOptions(Tool 목록)을 전달
- AI가 도구들의 @Description을 읽고 필요한 Tool 선정
- UserRepository에서 데이터베이스에 쿼리 전송
- 받은 데이터를 텍스트로 가공
- AI가 SystemMessage와 데이터로 최종 답변 생성
- 클라이언트 응답 수신
처음에는 어떻게 서비스에 AI를 도입할까에 대하여 엄청 걱정이었는데, 우리가 사용하는 ChatGPT나 Google Gemini 같은 서비스를 코드에 입력하는거나 다른게 없는 것 같았다. ‘이렇게 이렇게 답변해줘’라고 설명을 해주고, 데이터를 AI에게 전달하는 과정을 코드로 구현하는 것이었다. 규모가 큰 프로젝트라면 구조가 훨씬 복잡하겠지만 공부하는 입장이니까, 엄청 간단하게 구현했던 것 같다. 사실 구조가 복잡하기 보다는 쿼리를 얼마나 효율적으로 써서 데이터를 얼마나 깔끔하게 정리하느냐 일 수도 있을 것 같았다.
하루 하루가 지나면서 AI의 발전 속도는 너무 빠르고, AI를 누가 더 참신하게, 효율적으로 활용하고 서비스에 녹여내느냐의 차이가 될 것 같다. 다음에는 내 서비스에도 맞게 파인튜닝해보고 싶은 생각도 든다. (사실 해봤는데 데이터가 너무 적어서 말도 안 되는 헛소리를 해서 중간에 그만둔거..) 그리고 이런 AI를 실제로 하는 프로젝트면 더 좋고 사이드 프로젝트에 적극적으로 활용해서 경쟁력을 높여야겠다는 생각이 들었다.
'Backend > Java' 카테고리의 다른 글
| 어? 이제 RestTemplate은 Spring에서 권장하지 않는다구? (0) | 2026.08.23 |
|---|---|
| (Spring Boot) Elasticsearch를 활용해 1,000만 개 데이터에서의 검색 속도 개선해보기 (0) | 2026.08.23 |
| AWS 탈탈 털리고, Amazon Lightsail을 이용해 안전하게 파일 업로드 해보기 (Spring Boot) (0) | 2026.08.23 |
| Java Spring Boot에서 템플릿을 설정하고 이메일 발송하기 (0) | 2026.08.23 |
| 값이 반드시 유효해야 할 때: Spring Boot에서 Validation 처리하기 (0) | 2026.08.22 |